Een mixed ANOVA vergelijkt de gemiddelden tussen groepen die zijn verdeeld op twee factoren, waarbij de ene factor een “within-subjects” factor is en de andere een “between-subjects” factor.
Het doel van een mixed ANOVA is om te begrijpen of er een interactie is tussen deze twee factoren op de afhankelijke variabele.
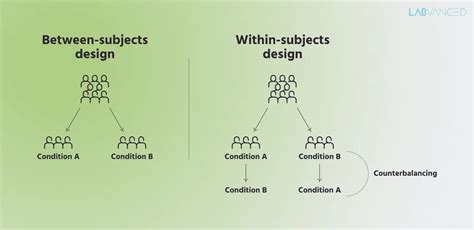
De between-subjects factor bestaat uit condities (ook wel behandelingen genoemd).
Stel dat een gezondheidswetenschapper wil onderzoeken of twee verschillende behandelingen effectiever zijn bij het verlichten van pijn over tijd; de afhankelijke variabele is pijn, de within-subjects factor is tijd, en de between-subjects factor is de behandeling.
De twee verschillende behandelingen worden aangeduid als “massageprogramma” (behandeling A) en “acupunctuurprogramma” (behandeling B).
In totaal nemen 60 deelnemers deel: 30 toegewezen aan behandeling A en 30 aan behandeling B.
Beide behandelprogramma’s duren 8 weken.
Aan het eind kan de mixed ANOVA bepalen of veranderingen in pijn het gevolg zijn van de interactie tussen type behandeling en tijd.
Een onderzoeker kan ook willen bepalen of stressniveaus veranderen naarmate men langer werkloos is en of er sprake is van interactie tussen leeftijdsgroep en werkloosheidsduur op stressniveaus.
In totaal zijn er 60 deelnemers verdeeld over drie leeftijdsgroepen met elk 20 deelnemers, wat de between-subjects factor “leeftijdsgroep” vormt.
Aan het eind wordt gekeken of verandering in stress (de afhankelijke variabele) het gevolg is van de interactie tussen leeftijdsgroep en tijd.
Fysieke activiteit en gender kunnen ook een rol spelen; de afhankelijke variabele kan depressie zijn, de within-subjects factor de drie trainingscondities (hoog, middel, laag) en de between-subjects factor gender.
Drie verschillende condities zijn: hoge intensiteit (behandeling A), middelste intensiteit (behandeling B) en lage intensiteit (behandeling C).
In totaal nemen 45 deelnemers deel en aangezien “intensiteit” een within-subjects factor is, ondergaan alle deelnemers alle drie behandelingen welke elk 4 weken duren.
De volgorde waarin de behandelingen wordt ontvangen is verdeeld over drie groepen; zo krijgen deelnemers in groep (a) A, dan B, dan C; groep (b) B, C, A; en groep (c) C, A, B.
Aan het eind bepaalt de mixed ANOVA of de verandering in depressie het gevolg is van de interactie tussen intensiteit en gender.
Zoals hierboven genoemd is het primaire doel van de mixed ANOVA om te begrijpen of er interactie is tussen de twee factoren op de afhankelijke variabele.
Zodra een statistisch significante interactie is vastgesteld, zijn er verschillende vervolgbenaderingen.
Het is belangrijk te realiseren dat de mixed ANOVA een omnibus-test is en niet aangeeft welke specifieke groepen binnen elk van de factoren significant van elkaar verschillen.
Wanneer een factor bijvoorbeeld drie tijdpunten heeft, kan de mixed ANOVA niet aangeven welke tijdpunten onderling verschillen; het geeft enkel aan dat ten minste twee van de drie groepen verschillen.
Omdat er vaak drie, vier of meer groepen per factor zijn, is het bepalen van welke groepen van elkaar verschillen essentieel.
Dit kan met post-hoc-toetsen, waar later in deze gids op wordt ingegaan.
Als je twijfelt of een mixed ANOVA geschikt is, kun je ook overwegen hoe het verschilt van een two-way repeated measures ANOVA.
Zowel de mixed ANOVA als de two-way repeated measures ANOVA hebben twee factoren en onderzoeken interactie, maar bij de two-way RM-ANOVA zijn beide factoren within-subjects, terwijl bij de mixed ANOVA één factor between-subjects is.
In een two-way repeated measures ANOVA ondergaan alle proefpersonen alle condities; bij een mixed ANOVA daarentegen ontvangen ze mogelijk slechts één conditie afhankelijk van de tussen-onderverdeling.
In deze snelle handleiding tonen we hoe je een mixed ANOVA met post hoc-toetsen uitvoert in SPSS Statistics en de interpretatie ervan stap voor stap toelicht.
Voordat we beginnen, is het cruciaal de zeven aannames voor een geldige mixed ANOVA te controleren; SPSS kan hier meerdere tests voor leveren.
Assumptie #1: de afhankelijke variabele moet op continu niveau gemeten zijn (interval of ratio).
Assumptie #2: de within-subjects factor moet bestaan uit ten minste twee categorische, gerelateerde groepen of gematchte paren.
Assumptie #3: de between-subjects factor moet bestaan uit ten minste twee categorische, onafhankelijke groepen.
Assumptie #4: er mogen geen significante outliers zijn in welke groep dan ook.
Assumptie #5: de afhankelijke variabele moet voor elke combinatie van de factoren ongeveer normaal verdeeld zijn; SPSS kan normaliteit controleren, bijvoorbeeld met de Shapiro-Wilk test of Q-Q plots.
Assumptie #6: er moet homogene varianties zijn voor elke combinatie van de factoren (Levene’s test).
Assumptie #7: sphericiteit, oftewel de varianties van de verschillen tussen de gerelateerde groepen van de within-subjects factor moeten gelijk zijn; SPSS biedt tests voor sphericiteit.
SPSS kan vervolgens helpen bij de procedure om een mixed ANOVA uit te voeren en de interpretatie van de resultaten te begeleiden.
In een voorbeeld van de zes maanden durende training met drie interventiegroepen werd de dependente variabele cholesterolconcentratie gemeten op drie tijdpunten; de tijdstippen vormen de within-subjects factor tijd en de groep-indelingen vormen de between-subjects factor.
Tijdens dit proces kan het nuttig zijn om de covariaten expliciet te benoemen als statistische controle, om variabiliteit buiten de manipulatie te corrigeren.
Een covariaat is een predictorvariabele die gedeelde variatie met de afhankelijke variabele verklaart en zo de “ruis” in het model kan verminderen.
Covariaten helpen de within-groupvariantie te verlagen, waardoor de testkracht toeneemt en het signaal-ruisverhouding verbetert.
Perfect onafhankelijke covariaten bestaan in de praktijk niet; in steekproeven kan toch een kleine samenhang bestaan tussen covariaat en manipulatie, wat de interpretatie vergt.
Wanneer sprake is van een significante interactie, kunnen vervolgpost-hoc-toetsen zoals Tukey of Games-Howell worden toegepast afhankelijk van de aanname over gelijke variances.
De resultaten worden gerapporteerd met F-waarden, vrijheidsgraden, en bijbehorende p-waarden; post-hoc-tests leveren aanvullende paarvergelijkingen.
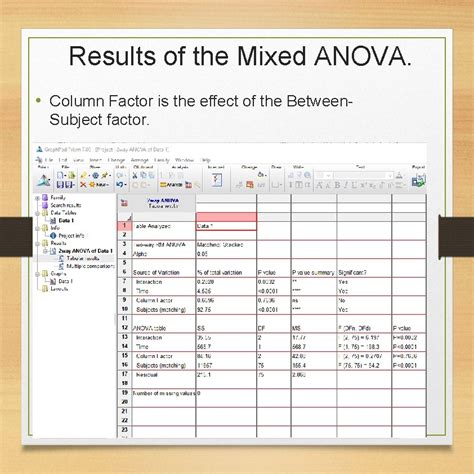
Voorbeeld uit de literatuur laat zien hoe de combinatie van within- en between-subjects factoren kan leiden tot significante verschillen tussen groepen in lange termijn studies.
Bij het interpreteren van een ANCOVA-achtige aanpak met covariaten is het belangrijk om de theoretische veronderstelling van de covariaat te verdedigen en te rapporteren.
Tot slot dient de rapportage in het resultatenhoofdstuk te bevatten: de relevante F-waarde, vrijheidsgraden, p-waarde en eventuele post-hoc-resultaten.
Mixed ANOVA in SPSS - calculation and interpretation in 6 minutes
In dit hoofdstuk wordt uitgelegd hoe covariaten een rol spelen bij het controleren voor ruis en hoe SPSS helpt bij het testen van aannames en uitvoeren van de analyse.
De procedure omvat het controleren van aannames, het selecteren van within- en between-subjects factoren, en het interpreteren van interacties gevolgd door post-hoc analyses wanneer nodig.
Het gebruik van covariaten in een mixed ANOVA kan non-responders of confounding variabelen compenseren door extra verklaarde variantie toe te voegen aan het model.
Een belangrijke nuance is dat het vertrouwen in de resultaten afhankelijk blijft van de mate waarin de aannames zijn onderzocht en gerapporteerd.
In SPSS kun je de variabelen toewijzen aan de juiste factoren en de analyses uitvoeren via de standaard procedure voor mixed ANOVA, inclusief eventuele covariaten en post-hoc tests.